ChatGPTの会話履歴が探せない理由と整理法
先月、競合の料金体系をChatGPTと一緒に整理したはずなのに、どのスレッドだったか思い出せない。サイドバーを上から眺めても、似たようなタイトルが並んでいるだけで判別がつかない。結局、同じ質問をもう一度投げ直すことになる。毎日ChatGPTを使っている人なら、この光景に覚えがあるはずです。そして多くの人が「自分の整理が下手なせいだ」と受け取ります。そうではありません。ChatGPTの会話履歴は、後から探すための設計になっていないだけです。時系列に積まれ、二度と開かれない。これは「あとで読む」リストが積読になる構造とまったく同じです。この記事では、なぜ探せないのかを4つに分解したうえで、明日から回せる運用に落とします。読み終える頃には、履歴を探す時間そのものが減っているはずです。
探せないのは記憶力ではなく構造の問題
まず結論から書きます。ChatGPTの履歴が探せないのは、会話履歴が「検索できるアーカイブ」ではなく「流れていくタイムライン」として設計されているからです。
サイドバーに並ぶスレッドは、新しいものが上に積まれ、古いものが下へ押し流されていきます。そこにあるのは更新時刻の順序だけで、内容による手がかりはほとんどありません。SNSのタイムラインや、チャットツールの過去ログと同じ構造です。
タイムラインは、流れている今を見るには優れた形式です。しかし「3か月前のあの判断」を取り出すには向きません。時間が経つほど、目的の1件は下へ沈んでいきます。
そして厄介なことに、ChatGPTの会話は溜まる速度が異常に速いです。ブックマークや「あとで読む」は、自分が良い記事に出会ったときだけ増えます。会話は、質問するたびに増えます。1日5回使えば、1か月で150件です。数百件を超えたあたりから、サイドバーは一覧ではなく背景になります。
溜まったものが視界から消えていく仕組みは、あとで読むが溜まる5つの理由と消化フローで扱った積読の構造とほとんど同じです。入口の摩擦がゼロに近く、出口の導線がない。その2つがそろうと、何でも溜まります。
ChatGPTの履歴が探せない4つの理由
「探しにくい」を漠然と受け止めていると、打ち手が出てきません。分解すると、詰まっている場所は4つです。
①タイトルが自動で付き、自分の検索語と一致しない
スレッドのタイトルは、最初のやり取りからChatGPTが自動で生成します。ここが最初のずれです。
自動命名は、会話の冒頭で使われた言葉を拾います。一方、後から探す自分が打ち込むのは、その会話で最終的に何が分かったか、あるいは何のために調べていたかの言葉です。「マーケティング施策の相談」というタイトルの中に、実は競合3社の料金比較が入っている。半年後の自分は「料金」で検索し、当然ヒットしません。
タイトルを付けたのが自分ではない、というのが本質です。自動命名は会話の入口を要約しますが、自分が思い出すときの手がかりは、たいてい会話の出口にあります。
②1つのスレッドに複数の話題が混ざる
ChatGPTとの会話は、自然に脱線します。記事構成の相談から始めて、途中で見出しの言い回しを詰め、ついでに競合の事例を調べ、最後にメールの文面まで書いてもらう。これが1本のスレッドに収まります。
会話としては自然な流れですが、検索の観点では最悪の形です。1件が複数の話題を抱えているため、どの話題の名前でも代表できません。タイトルは最初の話題のまま残り、後半の内容は存在ごと見えなくなります。
この混在は、続けて話すほうが文脈を引き継げて楽だ、という合理的な理由から起きます。だからこそ、意識しないと必ず起きます。
③価値があるのは会話全体ではなく、中の数行だけ
長い会話を掘り返して、実際に欲しいのは何でしょうか。ほとんどの場合、結論の数行です。
30往復した議論のうち、後から使うのは「結局この方針で行く」「この3社が候補」「この数字は出典がこれ」といった数行だけです。残りの大半は、そこにたどり着くための試行錯誤で、再利用の価値はほとんどありません。
にもかかわらず、保存されているのは会話全体です。価値のある数行が、価値のない大量のテキストの中に埋まっている。これでは、たとえスレッドを見つけられても、その中をもう一度スクロールして探す作業が残ります。「見つけたのに使えない」が起きる理由です。
④時系列以外の手がかりがない
フォルダにも入れていない、タグも付いていない、自分の言葉のメモもない。残っている手がかりは「いつ話したか」だけです。
しかも、その「いつ」もあてになりません。人の記憶は、内容は覚えていても時期は曖昧です。「たぶん先月」と思っていた会話が、実際には3か月前だったということは普通に起きます。時系列が唯一の手がかりで、その手がかりの精度が低い。探せないのは当然です。
4つとも、使う人の注意力や記憶力の問題ではありません。並び方と名前の付き方の問題です。
検索やプロジェクト機能で解決しきらない理由
「検索機能があるじゃないか」と思う方もいるはずです。実際、機能は年々良くなっています。
2026年9月時点では、ChatGPTは過去のスレッドを検索する機能を備えています。履歴検索は2024年10月に導入され、2026年1月には有料プラン(Plus/Pro)向けに強化されて、過去の会話を横断して情報を探し、参照したチャットを出典として提示できるようになりました。また、2025年4月にはメモリ機能が拡張され、過去の会話を参照したうえで応答する挙動も加わっています。会話をまとめる「プロジェクト」機能もあり、2025年9月以降は無料プランでも使えます。既存のスレッドを後からプロジェクトへ移すこともできます。
それでも、ここまで挙げた4つの理由のうち、機能が解決してくれるのは一部です。
検索が効くのは、そのとき打ち込んだ語が会話の中に実際に書かれていた場合です。「あの件」としか覚えていない会話は、どれだけ検索が賢くなっても指定できません。プロジェクト機能は入れ物を用意してくれますが、どのスレッドをどこに入れるかは自分で決める必要があり、決めるためには結局サイドバーを見返すことになります。2026年9月時点では入れ子のフォルダもないため、分類を作り込む余地も限られます。
そして何より、③の「価値は数行だけ」は機能では解決しません。会話全体が保存されている以上、必要な数行を取り出す作業は自分の側に残ります。
機能を使わないほうがいい、という話ではありません。検索もプロジェクトも使ったほうがいいです。ただ、それだけでは足りない部分がある、という前提で運用を組む必要があります。
ChatGPTは考える場所であって、残す場所ではない
ここが、この記事でいちばん伝えたい前提です。ChatGPTの中で情報を全部管理しようとすると、たいてい失敗します。
理由は単純で、役割が違うからです。ChatGPTは、考えを進めるための場所です。曖昧な問いを投げ、ずれた答えを直し、試しに書かせて、違うと思ったらやり直す。その往復がそのままログとして残ります。つまり残っているのは「思考の過程」であって、「整理された成果」ではありません。
過程を残す場所に成果を探しに行くから、見つからないのです。
この「過程を受ける場所」と「結論を残す場所」を分ける発想は、目新しいものではありません。NotionやObsidianのような母艦に未整理の情報を直接流し込むと散らかる、という話と同じ構造です。母艦と一次受けを分ける設計はNotion・Obsidianの「一次受け」を作る設計で詳しく扱っています。
ChatGPTを母艦にしてはいけない理由も、そこで挙げた理由と重なります。ChatGPTは入口の摩擦が極端に低く、判断前の雑多なやり取りをいくらでも受け止めてしまいます。受け止める能力が高いほど、母艦には向きません。
実践:3つの操作で探せる状態にする
前提が決まったので、具体的な操作に落とします。やることは3つです。上から順に、かかる手間が増えていきます。
スレッドを話題ごとに切る
新しい話題に移ると思ったら、続けずに新しいスレッドを開きます。これが最も費用対効果の高い操作です。
判断の基準は「この話題だけで名前を付けられるか」です。記事構成の相談をしていて、途中で別記事の競合調査に移るなら、そこで切ります。文脈を引き継ぎたい場合は、前の会話の結論を数行だけコピーして新しいスレッドの冒頭に貼れば十分です。全部を引き継ぐ必要はありません。
1スレッド1話題にしておくと、②の混在が消えるだけでなく、①のタイトルも精度が上がります。冒頭の話題が会話全体の話題と一致するので、自動命名が的を射やすくなるからです。
タイトルを自分の言葉に直す
会話が終わったら、タイトルを手で書き直します。5秒で終わります。
書き換えるときのコツは、会話の要約を書かないことです。書くのは、未来の自分がこの会話を探すときに打ち込みそうな語です。
- 「競合3社 料金プラン 比較 2026年9月調べ」
- 「LP見出し 案出し ボツ案も含む」
- 「決算資料の読み方 用語メモ」
自動命名なら「マーケティングの相談」で終わっていたものが、「競合」「料金」「2026年9月」で引けるようになります。要約しようとすると手が止まりますが、「何で探すか」なら即座に決まります。
検索語を入れる発想は、URLを保存するときにメモを添える話と同じです。詳しくは技術記事を死蔵させないストック運用術で扱っていますが、原則は共通しています。保存の瞬間に、未来の検索語を1つ置いておく。それだけで引ける確率が変わります。
結論が出たら、会話の外に出す
ここが山場です。会話の中で結論が出たら、その結論を会話の外へ転記します。
転記先は、普段から使っているドキュメントでもノートアプリでも構いません。大事なのは、ChatGPTの中ではないことです。出す内容は3つに絞ります。
- 結論の数行。何を決めたか、何が分かったか。文章にしなくても箇条書きで十分です。
- その結論に至った理由。採用しなかった選択肢と、なぜ外したかも1行残します。後から効いてくるのはこちらです。
- 出典として使ったURL。ChatGPTが提示したリンクや、自分が読んで裏を取ったページのアドレスです。
転記してしまえば、元の会話は使い捨てにできます。これが発想の転換点です。会話を資産として保管しようとするから、探せないことが問題になります。会話は使い捨て、成果物だけが残ると決めてしまえば、履歴が何百件あっても困りません。探す必要がなくなるからです。
転記の手間は、実際には1〜2分です。もう一度同じ調査をやり直す時間と比べれば、はるかに安く済みます。
出典に使ったURLは、会話と別に保存する
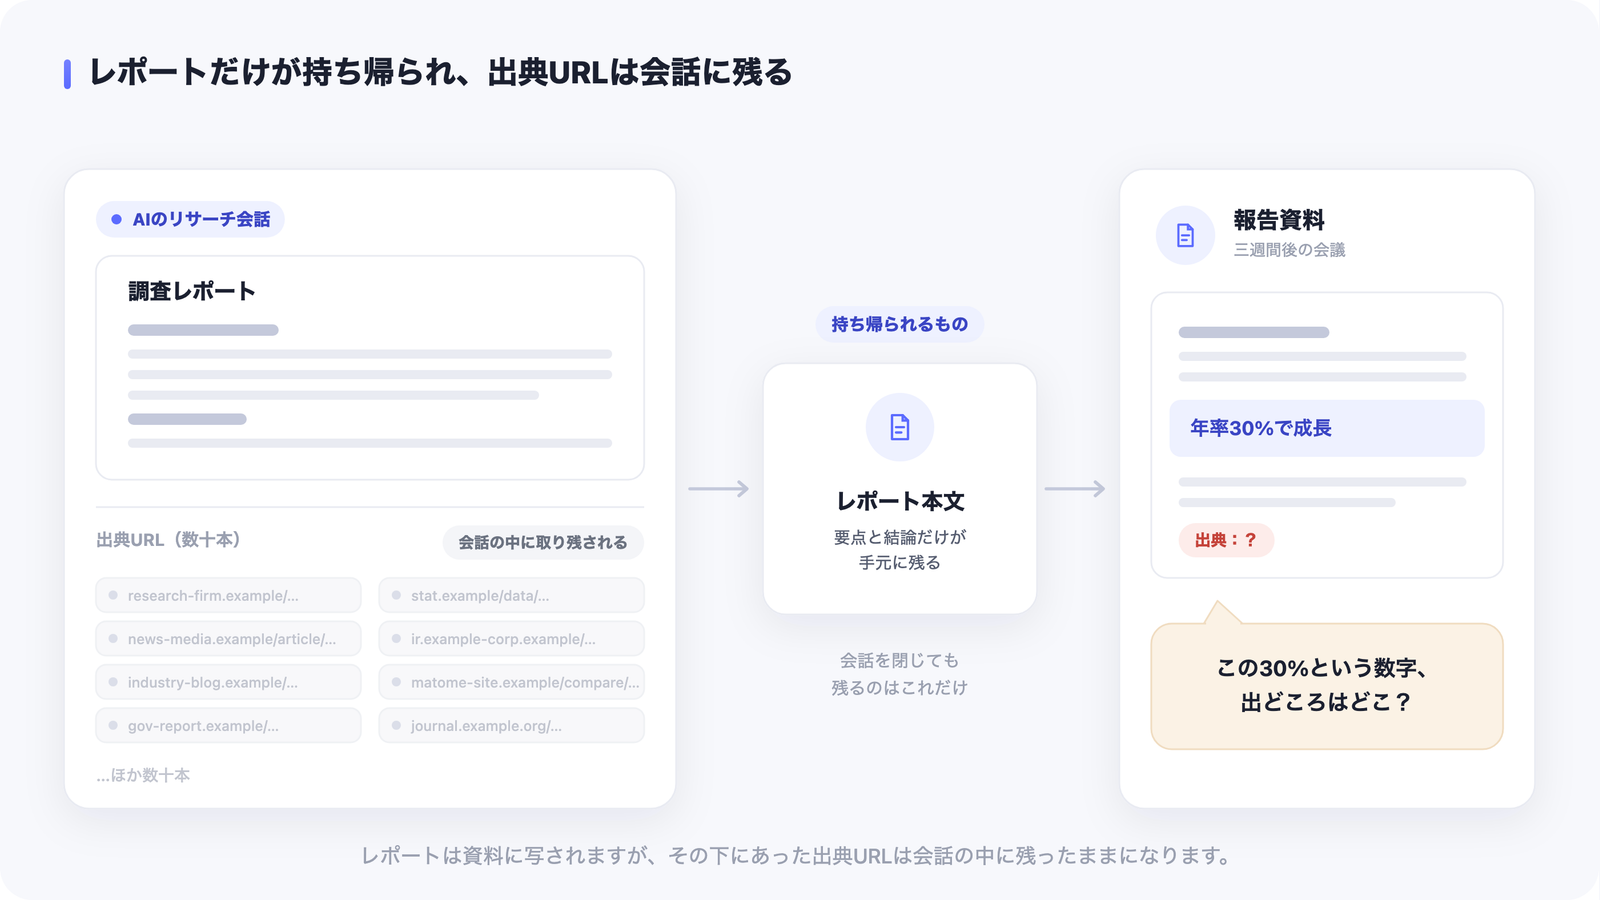
3つ目の「外に出す」の中でも、URLは特別に扱ったほうがうまくいきます。理由は、URLだけは会話の中に置いておくと二重に見つけにくくなるからです。
ChatGPTに調べてもらうと、参考リンクがまとめて出てきます。その場では全部読めません。しかしリンクは会話の中にあるので、あとで読もうとすると「あの会話を探す」という一手間が先に必要になります。探せない会話の中に、読みたいURLが人質に取られている状態です。
だから、使えそうなURLはその場で会話の外に保存します。保存するときに、会話のどの文脈で出てきたURLなのかを一言添えておくと、後から効きます。「競合の料金ページ。改定前の価格が残っているスクショあり」といった程度で十分です。
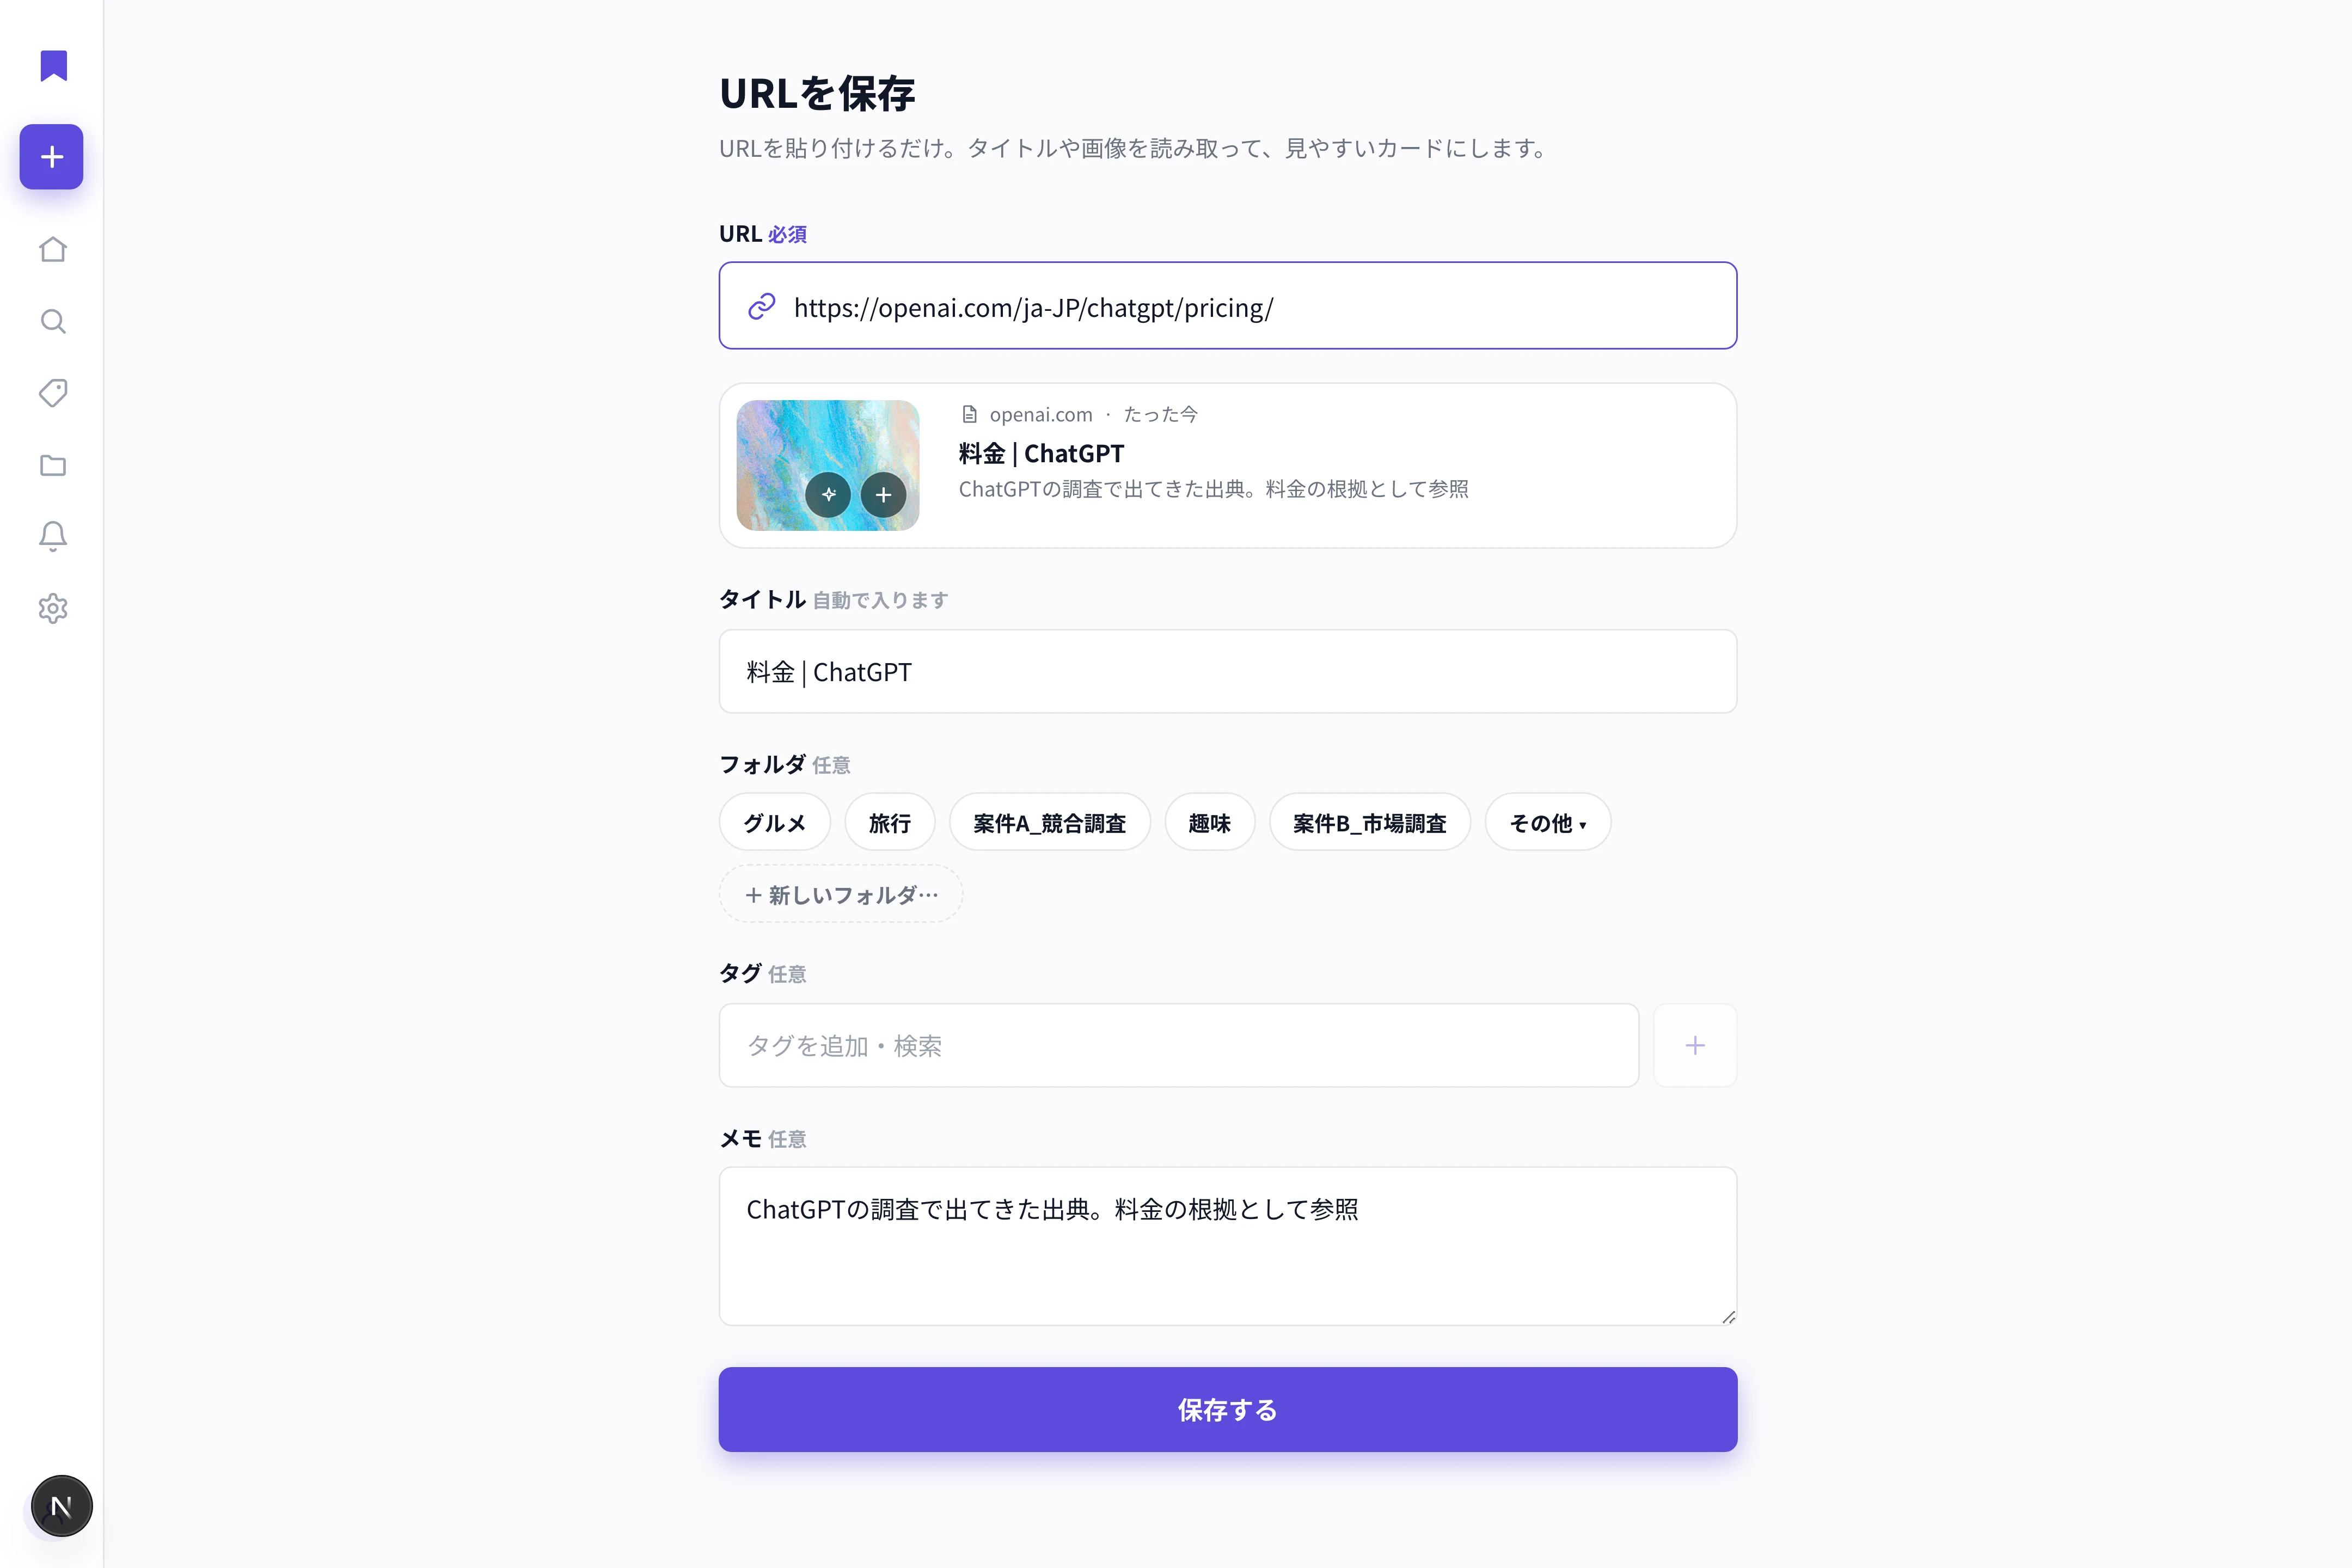
LaterListは、URLを貼るだけでタイトルやサムネイル、説明を自動で取得し、その場でメモを添えられます。フォルダやタグで分けられ、メモの文言まで含めた横断検索もあるので、「調査のときに参照したURL」を会話と切り離して置いておく用途には素直に当てはまります。保存したデータの書き出しは上位プランの機能です。しばらく見返していないURLをホームに表示する仕掛けもあるので、調査のときに集めたまま眠っているリンクを目の前に戻せます。
道具は何でも構いません。原則は1つで、判断に使ったURLを会話の中に置き去りにしないことです。
捨てていい会話と、残す価値のある会話
ここまでの運用が回り始めると、次に出てくるのが「どれを消していいのか」という問いです。基準を先に決めておくと、迷いが判断に変わります。
捨てていい会話は、結論を外に出し終えたものです。転記が済んでいれば、元の会話に戻る理由はもうありません。文章の推敲、翻訳、コードの単発の書き換え、言い回しの案出しといった、成果物が手元に残る作業も同様です。成果物がある時点で、過程を保管する意味は薄くなります。事実確認のような、答えが1つに決まる質問も消して構いません。同じ質問をすればまた答えが返ってきます。
残す価値のある会話は、次の3つです。
1つ目は、過程そのものに情報がある会話です。十数往復かけて考えを詰めたもの、前提を何度も置き直したもの。結論だけを転記すると、なぜそこに着地したかが落ちます。この場合は転記に加えて会話も残し、タイトルに「検討の経緯あり」と書き足しておきます。
2つ目は、自分の文脈を大量に渡した会話です。自社の状況、過去の経緯、細かい制約条件などを説明したうえで得た回答は、再現に手間がかかります。同じ前提で続きを話す可能性があるなら、残す価値があります。
3つ目は、ボツ案が並んでいる会話です。採用しなかった案の一覧は、後から「その方向は検討済み」と示すのに使えます。ただしこれも、ボツにした理由を一言だけ外に転記しておくほうが確実です。
判断に迷ったら、「結論は外に出したか」だけを見てください。出してあるなら消してよく、出していないならまず出す。それが済んでから、残すかどうかを考えます。
整理の手を増やすより、外に出す習慣が1つ回るほうが効きます。スレッドを切る、タイトルを直す、結論を外に出す。この3つのうち、まず最後の1つだけでも今日の会話から試してください。
FAQ
Q. ChatGPTの履歴は全部残しておくべきですか。
いいえ。結論を会話の外に転記し終えたものは、消して構いません。会話に残っているのは思考の過程であって、整理された成果ではないからです。残す価値があるのは、過程そのものに情報がある会話、自分の状況や制約を大量に渡したうえで得た回答、ボツ案が並んでいる会話の3つです。迷ったときは「結論は外に出したか」だけで判断してください。出してあるなら消せます。
Q. プロジェクト機能でフォルダ分けすれば解決しますか。
一部は解決しますが、十分ではありません。2026年9月時点では、プロジェクト機能でスレッドをまとめられ、既存の会話を後から移すこともできます。ただし、どのスレッドをどこに入れるかは自分で判断する必要があり、そのためにサイドバーを見返す手間は残ります。また、後から使いたいのは会話全体ではなく中の数行であることが多く、これは入れ物を整えても解決しません。フォルダ分けより先に、結論を会話の外へ出す運用を作るほうが効きます。
Q. スレッドのタイトルは毎回付け直す必要がありますか。
全部に付け直す必要はありません。自動で付くタイトルは会話の冒頭を要約しますが、後から探すときに使う言葉は会話の出口にあることが多く、そこがずれます。付け直す対象は、後から参照しそうな会話だけで十分です。書くのは要約ではなく、未来の自分が打ち込みそうな検索語にしてください。「競合3社 料金プラン 比較 2026年9月調べ」のように具体的な語が入っていれば、5秒の書き換えで引ける確率が上がります。