ディープリサーチの出典を捨てずに確認する実務フロー
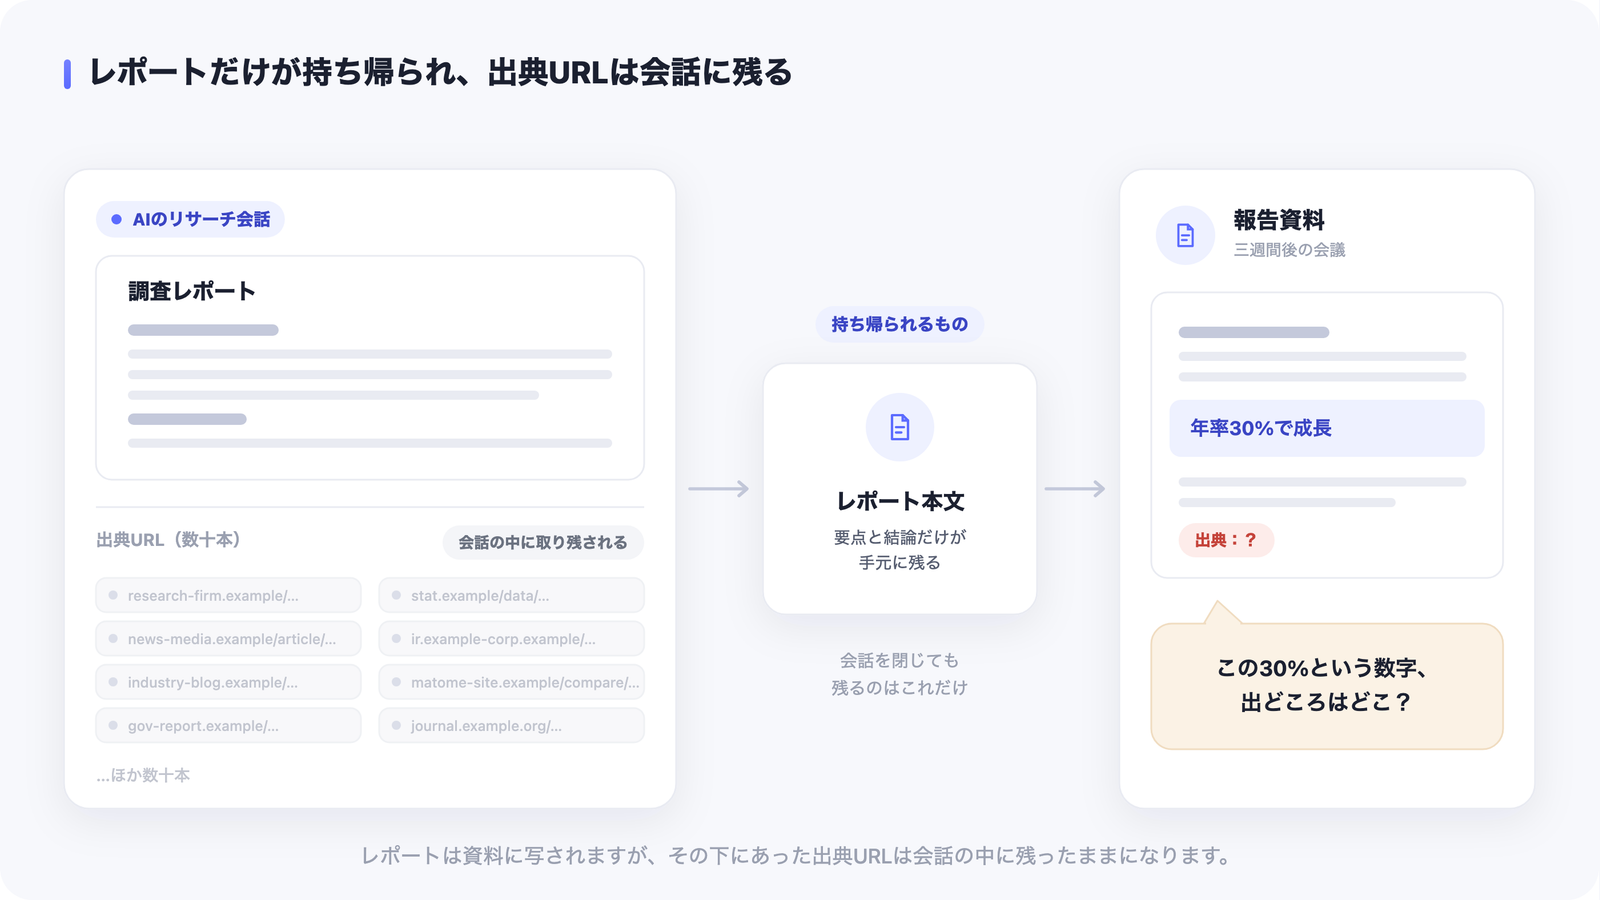
ディープリサーチに市場規模を調べさせて、15分後に章立ての整ったレポートが返ってくる。読むと筋が通っている。要点を報告資料に写して、会話は閉じる。三週間後の会議で「この30%という数字、出どころはどこ?」と聞かれ、そこで初めて手が止まる。レポートの下には、確かに出典のURLが並んでいました。ただしそれは会話の中にあり、会話を閉じた時点で実質的に手元から消えています。探そうとしても、あの日どの会話でどんなプロンプトを投げたかを思い出すところからになります。この記事の立場ははっきりしています。AIのリサーチ機能が短くしたのは「情報を集める工程」だけで、「その情報を信じてよいか決める工程」は人間に残っている。そして後者を回すには、出典URLが会話の外に残っている必要があります。以下では、出典が捨てられる構造的な理由、全部は読まずに確認対象を絞る基準、出典の仕分け、リサーチ直後の10分でやること、チームでの回し方までを、業務フローとして通しで解説します。
出典URLは、なぜ会話ごと捨てられるのか
保存する気がないから捨てられるわけではありません。捨てられやすい条件が3つ重なっているからです。
会話の中に埋まっている。出典URLは、レポートの一部としてその会話画面に置かれています。リサーチが終わった直後は目の前にありますが、次の作業に移った瞬間、それは「過去の会話」になります。ブラウザのタブやブックマークと違って、日常的に開く場所には出てきません。
数が多すぎて、読む気にならない。一度のリサーチで数十本の出典が並ぶことは珍しくありません。全部開いて読む時間はない。かといって一部だけ選ぶ基準もない。結果として、どれも開かないまま終わります。「全部読むか、ゼロか」の二択になってしまうのが、この工程の最大の落とし穴です。
レポートが完成品に見える。これが一番やっかいです。見出しが立ち、比較表が入り、注釈まで付いた文書が出てくると、それは下書きではなく成果物のように見えます。人は完成品を検証しません。手書きのメモなら「裏を取らないと」と思うのに、整ったレポートには同じ警戒心が働きにくい。
3つとも、本人の注意力の問題ではありません。出典を確認する工程が業務の手順に組み込まれていないから、毎回その場の判断になり、その場の判断はたいてい「後で」になります。
AIが変えたのは、集める工程だけ
リサーチという仕事を分解すると、大きく2つの工程に分かれます。
1つは集める工程です。検索語を考え、検索結果を開き、関係ありそうなページを拾い、要点を抜き出して並べ直す。ここは、AIのリサーチ機能が劇的に短くした領域です。2026年9月時点では、ChatGPT の deep research は数分から数十分かけて多数のページを読み、出典付きの構造化されたレポートを返します。同種の機能は Gemini、Perplexity、Claude にもあり、いずれも「出典を示したレポートを出す」ところまでを担います。
もう1つは信じてよいか決める工程です。その数字は誰が、いつ、どういう定義で出したものか。その調査の対象は自分たちの市場と同じか。引用元は一次情報か、誰かの要約か。ここは短くなっていません。なぜなら、この判断には「何に使うのか」という目的が要るからです。同じ統計でも、社内の議論のたたき台に使うのか、対外的な提案書に載せるのかで、求められる確度が変わります。目的を持っているのは人間の側です。
もうひとつ押さえておきたいのは、出典が示されていることと、その出典が主張を裏づけていることは別だという点です。引用の付いた文が、その引用元を読むと少しずれた内容だった、というケースは起こりえます。この種のずれは、レポートだけを眺めていても見つかりません。元のページを開いて、書いてある数字と突き合わせて初めて分かります。
つまり、AIが集める、人が検証するという分業が成立する条件は1つだけで、出典URLが会話の外に、後から開ける形で残っていることです。逆に言えば、そこさえ押さえれば、空いた時間は検証に回せます。
全部は読まない。確認する対象を絞る3つの基準
ここがこの記事の実用的な山場です。数十本の出典を全部当たるのは現実的ではなく、やろうとすれば結局ゼロになります。読む対象を絞る基準を先に決めておくのが、唯一機能するやり方です。
基準1:その数字1つで結論が変わる箇所
最優先で一次情報まで辿るのは、それが違っていたら報告の結論が変わってしまう主張です。
レポートには、結論を支える数字と、雰囲気を作る数字が混ざっています。「市場は年率30%で伸びている、だから参入すべき」と書いてあるなら、30%は結論を動かす数字です。一方、「主要プレイヤーは5社前後」といった記述は、4社でも6社でも提案の中身は変わりません。
見分け方はシンプルで、その数字を消してみて、結論が残るかどうかです。残らないなら、そこは確認対象です。1本のレポートで、この条件に当てはまるのはたいてい3つから5つに収まります。数十本の出典のうち、開くべきは実はその数本だけ、ということが多い。
基準2:二次情報が出典になっている箇所
次に見るのは、出典が「誰かのまとめ」になっている箇所です。
ニュース記事、業界ブログ、比較まとめサイトが出典として挙がっているとき、そこに書かれた数字にはたいてい元があります。調査会社のレポート、官公庁の統計、企業のIR資料。まとめ記事は、その元データを引用する過程で、対象期間を削ったり、単位を丸めたり、注記を落としたりします。悪意ではなく、読みやすくするための省略です。しかしその省略された注記こそが、自分たちの用途に合うかどうかを決めることがあります。
やることは、まとめ記事を開いて、その記事が引いている元をさらに辿ることです。一段階でかまいません。元の発行元名と公表年が確認できれば、引用の精度は大きく上がります。元が辿れないまとめ記事は、報告資料の出典としては使わない、と決めておくのが安全です。
基準3:古い統計と、もう開かないページ
三番目は、時点と生存の確認です。ここは確認そのものが数秒で終わるので、対象を絞らず機械的にやってかまいません。
見るのは2点です。1つは調査時点で、統計の値そのものではなく「いつの調査か」を見ます。制度や市場の前提が変わった後なのか前なのかで、同じ数字の意味が変わります。もう1つはページの生存で、開いてみてリンク切れになっていたり、別ページへ飛ばされたりするものは、そのまま出典にはできません。
この3つを通すと、確認作業は「数十本を読む」から「数本を開いて突き合わせる」に変わります。所要時間は、慣れれば20分から30分です。集める工程が短くなった分は、ここに充てるべき時間です。
出典URLを3つに仕分ける
確認を通した出典は、次の3つに分けます。仕分けの目的は、報告資料に載せる段階で迷わないようにすることです。
そのまま載せる。一次情報で、発行元と調査時点が明記されていて、レポートの記述と実際の内容が一致しているもの。出典欄にURLと確認日を書けば、それで完了です。
自分で確認してから載せる。一次情報だが、数字の定義や調査対象の範囲が自分の用途と一致しているか読み切れていないもの。あるいは二次情報経由で、元は辿れたが原典を読み込めていないもの。この層は、保留したまま保存しておくのが正解です。報告資料の締め切りまでに読めればそれでよく、読めなければ資料からは外します。
捨てる。開いてみたら主張を裏づけていなかったもの、発行元や日付が分からないもの、そもそも自分が扱う論点とずれているもの。ここで捨てる判断をしておくと、次に同じテーマを調べるときに同じページを開き直さずに済みます。
3つのうち、実務でいちばん価値があるのは真ん中の「保留」です。ここを置ける場所がないと、確認しきれなかった出典は「載せる」か「消える」のどちらかに寄ってしまいます。判断が付く前の情報をいったん受け止める置き場を用意する考え方は、Notion・Obsidianの「一次受け」を作る設計で扱っています。AIが出したレポート本体は成果物の母艦へ、出典URLは一次受けへ、と役割を分けると整理しやすくなります。
リサーチが終わった直後の10分でやること
仕組みとして回すには、手順を時間で区切っておくのが確実です。リサーチが終わったその場で、10分だけ使います。
1. 出典URLを案件のフォルダへ退避する(3分)
まず、レポートの中身を読み込む前に、出典URLをまとめて案件のフォルダへ移します。ここで選別はしません。選別は退避の後です。逆にすると、選別の途中で集中が切れたときに、残りが会話の中に取り残されます。
器となるフォルダは、リサーチを始める前に作っておくのが理想です。案件ごとに1フォルダを先に用意する考え方は、競合調査のURLが散らからない案件別整理法で詳しく書いています。ディープリサーチの出典は、その案件フォルダに流し込む材料のひとつだと捉えてください。
2. レポート側に印をつける(3分)
次に、レポートを読み返しながら、前の章の基準1に当てはまる主張、つまり「その数字1つで結論が変わる」箇所に印をつけます。この時点ではまだ出典を開きません。印をつけるだけです。3つから5つに収まるはずです。
3. 印のついた主張の出典だけ開き、メモを1行残す(4分+α)
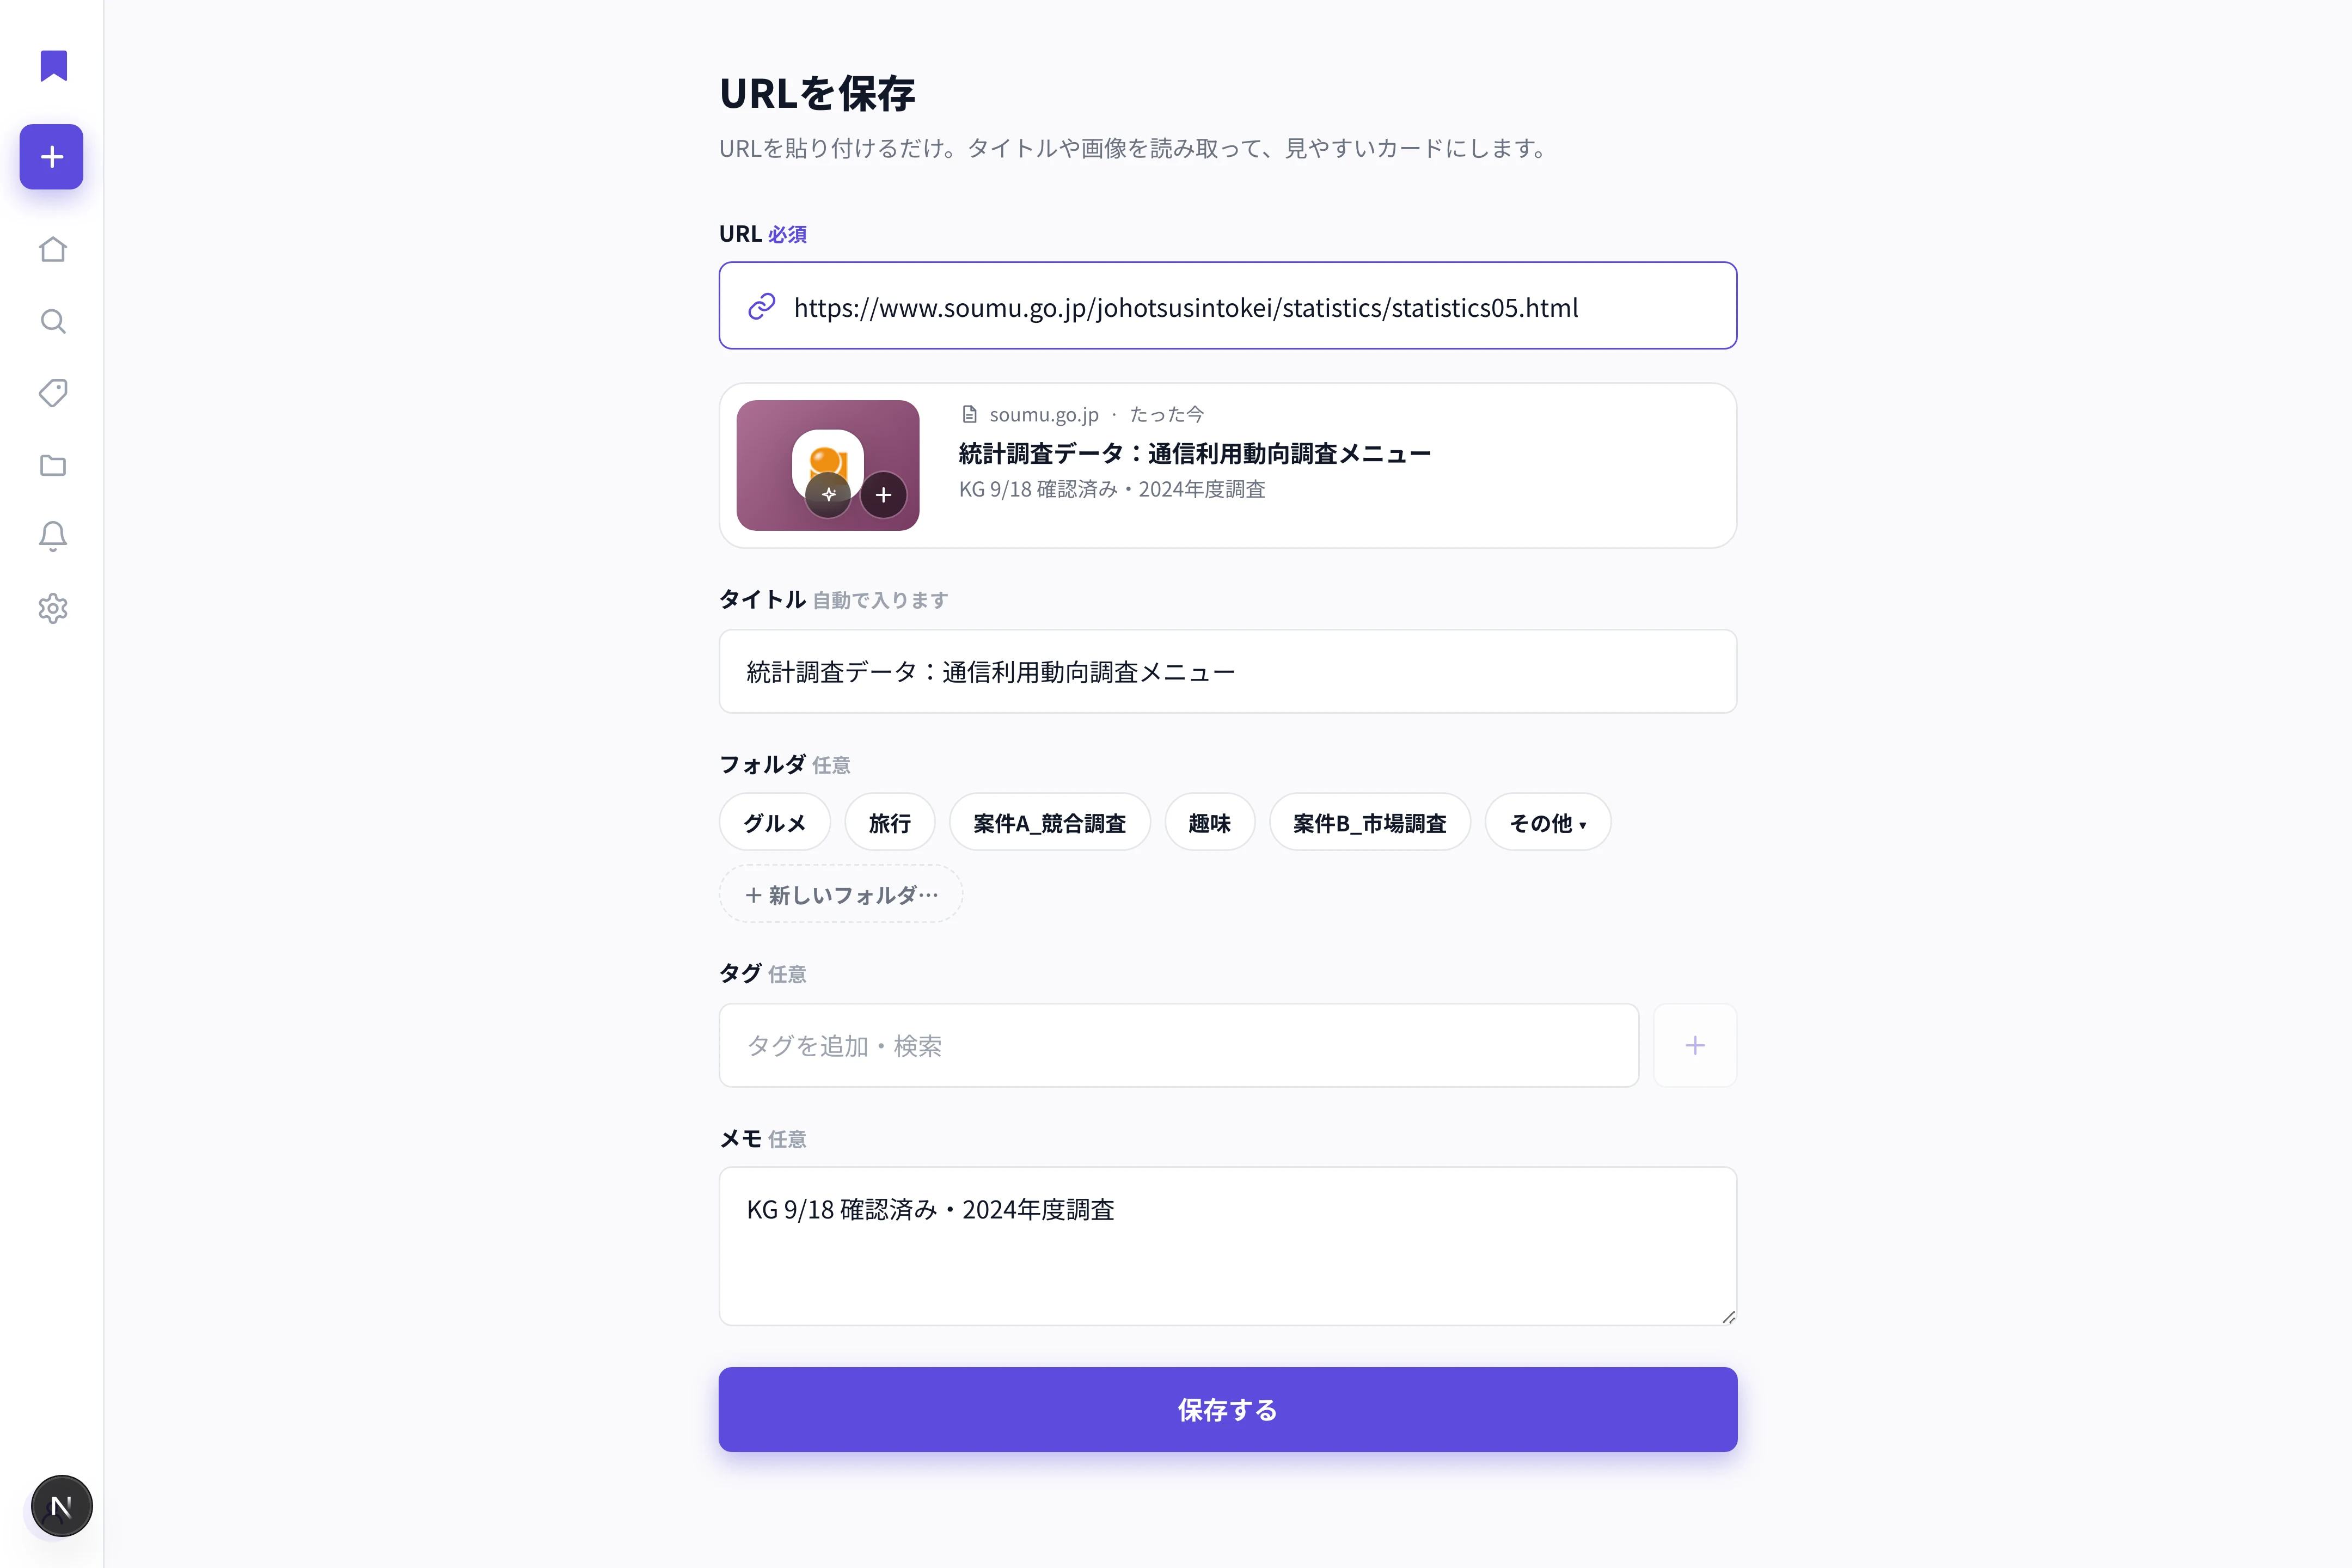
印をつけた主張に対応する出典を開きます。ここで残すのは、確認した結果の1行です。「確認済み・2024年度調査」「定義が自社の対象と違う、要注意」「元記事に当たれず」。この一言が、後から報告資料を作るときの判断材料になり、同時に未来の検索語にもなります。
保存の瞬間に残した一言が後から効いてくる仕組みは、技術記事を死蔵させないストック運用術で詳しく扱っています。出典URLの場合、書くべき一言は「なぜ保存したか」ではなく「確認した結果どうだったか」です。
4. 報告資料へ転記する(後日)
資料を作る段階で、「そのまま載せる」に仕分けた出典を出典欄へ写します。このときURLと確認日を必ず併記します。Webページは書き換わるので、確認日がないと後から検証のしようがありません。冒頭の「この数字どこから来たの」に即答できるかどうかは、ここで決まります。
5. 案件が終わったらアーカイブする
報告が終わったら、案件フォルダは日常的に見える場所から外します。削除はしません。同じテーマを再び調べる機会はかなりの確率で訪れますし、そのとき「前回どの出典を確認して、何を捨てたか」が残っていれば、二度目のリサーチは検証から始められます。
チームで使うなら「誰が確認したか」を残す
同じリサーチを複数人で回す場合、追加で必要になるのは1つだけです。その出典を誰がいつ確認したかが分かる状態にしておくこと。
理由は2つあります。1つは重複の防止です。検証は時間のかかる工程なので、同じ一次情報を二人が開くのは純粋な損失です。もう1つは、より重要で、未確認のものが未確認だと分かるようにするためです。誰も印をつけていない出典は、放っておくと「たぶん誰かが見た」という扱いになり、そのまま資料に載ります。事故はほぼここで起きます。
やり方は重くしないのがコツです。メモの先頭に確認者のイニシャルと日付を足す、それだけで十分です。「KG 9/18 確認済み」「未確認」。ツールの機能ではなく、チーム内の書式として先に決めておきます。
もうひとつ決めておくとよいのは、AIのリサーチ結果をそのまま他人に渡さないという原則です。渡すのはレポートではなく、印をつけて仕分けた後の出典と、確認結果の1行。受け取る側からすれば、整ったレポートよりも「この3本は裏が取れている、この2本は未確認」という情報のほうが、はるかに使えます。
引き継ぎのときも同じ構造が効きます。案件フォルダが1つあり、各URLに確認結果が添えられていれば、口頭の説明はほとんど要りません。
出典の置き場に求める4つの条件
ここまでの運用を支える道具の条件は、次の4つです。
- 会話の外にある:AIのサービスとは独立した場所に置けること。チャットの履歴に依存した時点で、この運用は成立しません。
- 保存が速い:数十本のURLを数分で流し込めること。1本ずつ手間がかかる置き場は、忙しい日に使われなくなります。
- メモを後から足せる:保存時ではなく、確認した後に1行書き足せること。出典管理では、この後追いの書き足しが本体です。
- 案件単位で束ねられて、横断検索できる:進行中の案件を分けつつ、過去案件の出典も引けること。
たとえばLaterListは、URLを貼るだけでタイトルやサムネイル、説明文を自動で取得し、メモを添えて保存できます。フォルダで案件ごとに分けられ、フォルダはチームで共有することもできます。横断検索があるので、「確認済み」といったメモの文言から後で引き直せます。既読の記録があるため、すでに目を通した出典を一覧の中で区別できます。
なお、2026年9月時点では、ChatGPT の deep research は無料プランと Go プランでは利用が限られ、Plus・Business・Enterprise で月25回、Pro で月250回という提供になっています。2026年2月の更新では、検索対象を信頼できるサイトに限定する機能や、最終レポートの表示改善が入りました。入口の側で対象を絞れるようになった分、出口の側でも仕分けの基準を持っておくと、全体の精度が上がります。
AIが集める、人が検証する
ディープリサーチを使い始めた人が最初に感じるのは、「調べる時間がこんなに減るのか」という驚きだと思います。その驚きのまま、レポートを成果物として扱ってしまうと、検証されていない数字が資料に載ります。
けれども、見方を変えれば話は単純です。集める工程が短くなった分、検証に時間を回せるようになった。以前は、検索して読んで並べ直すだけで半日が消え、一次情報まで辿る余力は残りませんでした。いまは30分で材料が揃い、残った時間を「この数字は信じてよいか」に使えます。リサーチの質は、むしろ上げやすくなっています。
そのために必要な準備は、拍子抜けするほど小さい。リサーチを始める前に案件のフォルダを1つ作り、終わった直後の3分で出典URLをそこへ移す。あとは、結論を動かす数本だけを開いて、1行のメモを残す。この手順が回り始めた時点で、報告資料の数字は「どこから来たのか」を答えられるものになります。
FAQ
Q. 出典URLは、何本くらい確認すれば十分ですか。
本数ではなく、性質で決めてください。優先するのは「その数字が違っていたら結論が変わる」主張の出典で、1本のレポートにつき3つから5つに収まることがほとんどです。加えて、二次情報が出典になっている箇所は元を一段階だけ辿ります。残りは開かずに保存しておき、必要になった時点で確認すれば間に合います。数十本を全部読もうとすると、結局ゼロ本になります。
Q. AIが示した出典が、本文の主張と合っていないことはありますか。
起こりえます。出典が示されていることと、その出典が主張を裏づけていることは別の話で、引用元を開くと記述が少しずれている、というケースは知られています。これはレポートだけを読んでいても見つかりません。対策は難しくなく、結論を動かす数字についてだけ元のページを開き、書かれている数値と定義を突き合わせることです。対象を絞れば、1本あたり数分で終わります。
Q. 出典URLを全部保存すると、置き場がすぐ散らかりませんか。
案件ごとにフォルダを分けておけば散らかりません。逆に、案件という単位を持たずに1つの場所へ流し込むと、先週の調査と今週の調査の出典が混ざります。加えて、報告が終わった案件のフォルダはアーカイブして、日常的に見える場所から外してください。進行中の案件と終わった案件が同じ画面に並ばないようにするだけで、保存件数が増えても運用は保てます。